

 로그인을 하시면 메디칼타임즈의
다양한 연관서비스를 이용하실 수 있습니다. 가입 시 등록한 정보를 입력해주세요.
개인정보 보호를 위한 비밀번호 변경안내
주기적인 비밀번호 변경으로 개인정보를 지켜주세요.안전한 개인정보 보호를 위해 3개월마다 비밀번호를 변경해주세요. ※ 비밀번호는 마이페이지에서도 변경 가능합니다.


- 의료기기·AI.
- 진단
'안전하다'는 의료 AI, 증거를 대라(상)

-
가
-
 URL복사
-
-


/NewsMain.jpg)

[유소영 박사의 의료AI와 윤리]
유소영 서울아산병원 임상연구보호센터 · 빅데이터연구센터
울산대학교 의과대학 인문사회의학교실 · 정보의학통계교실
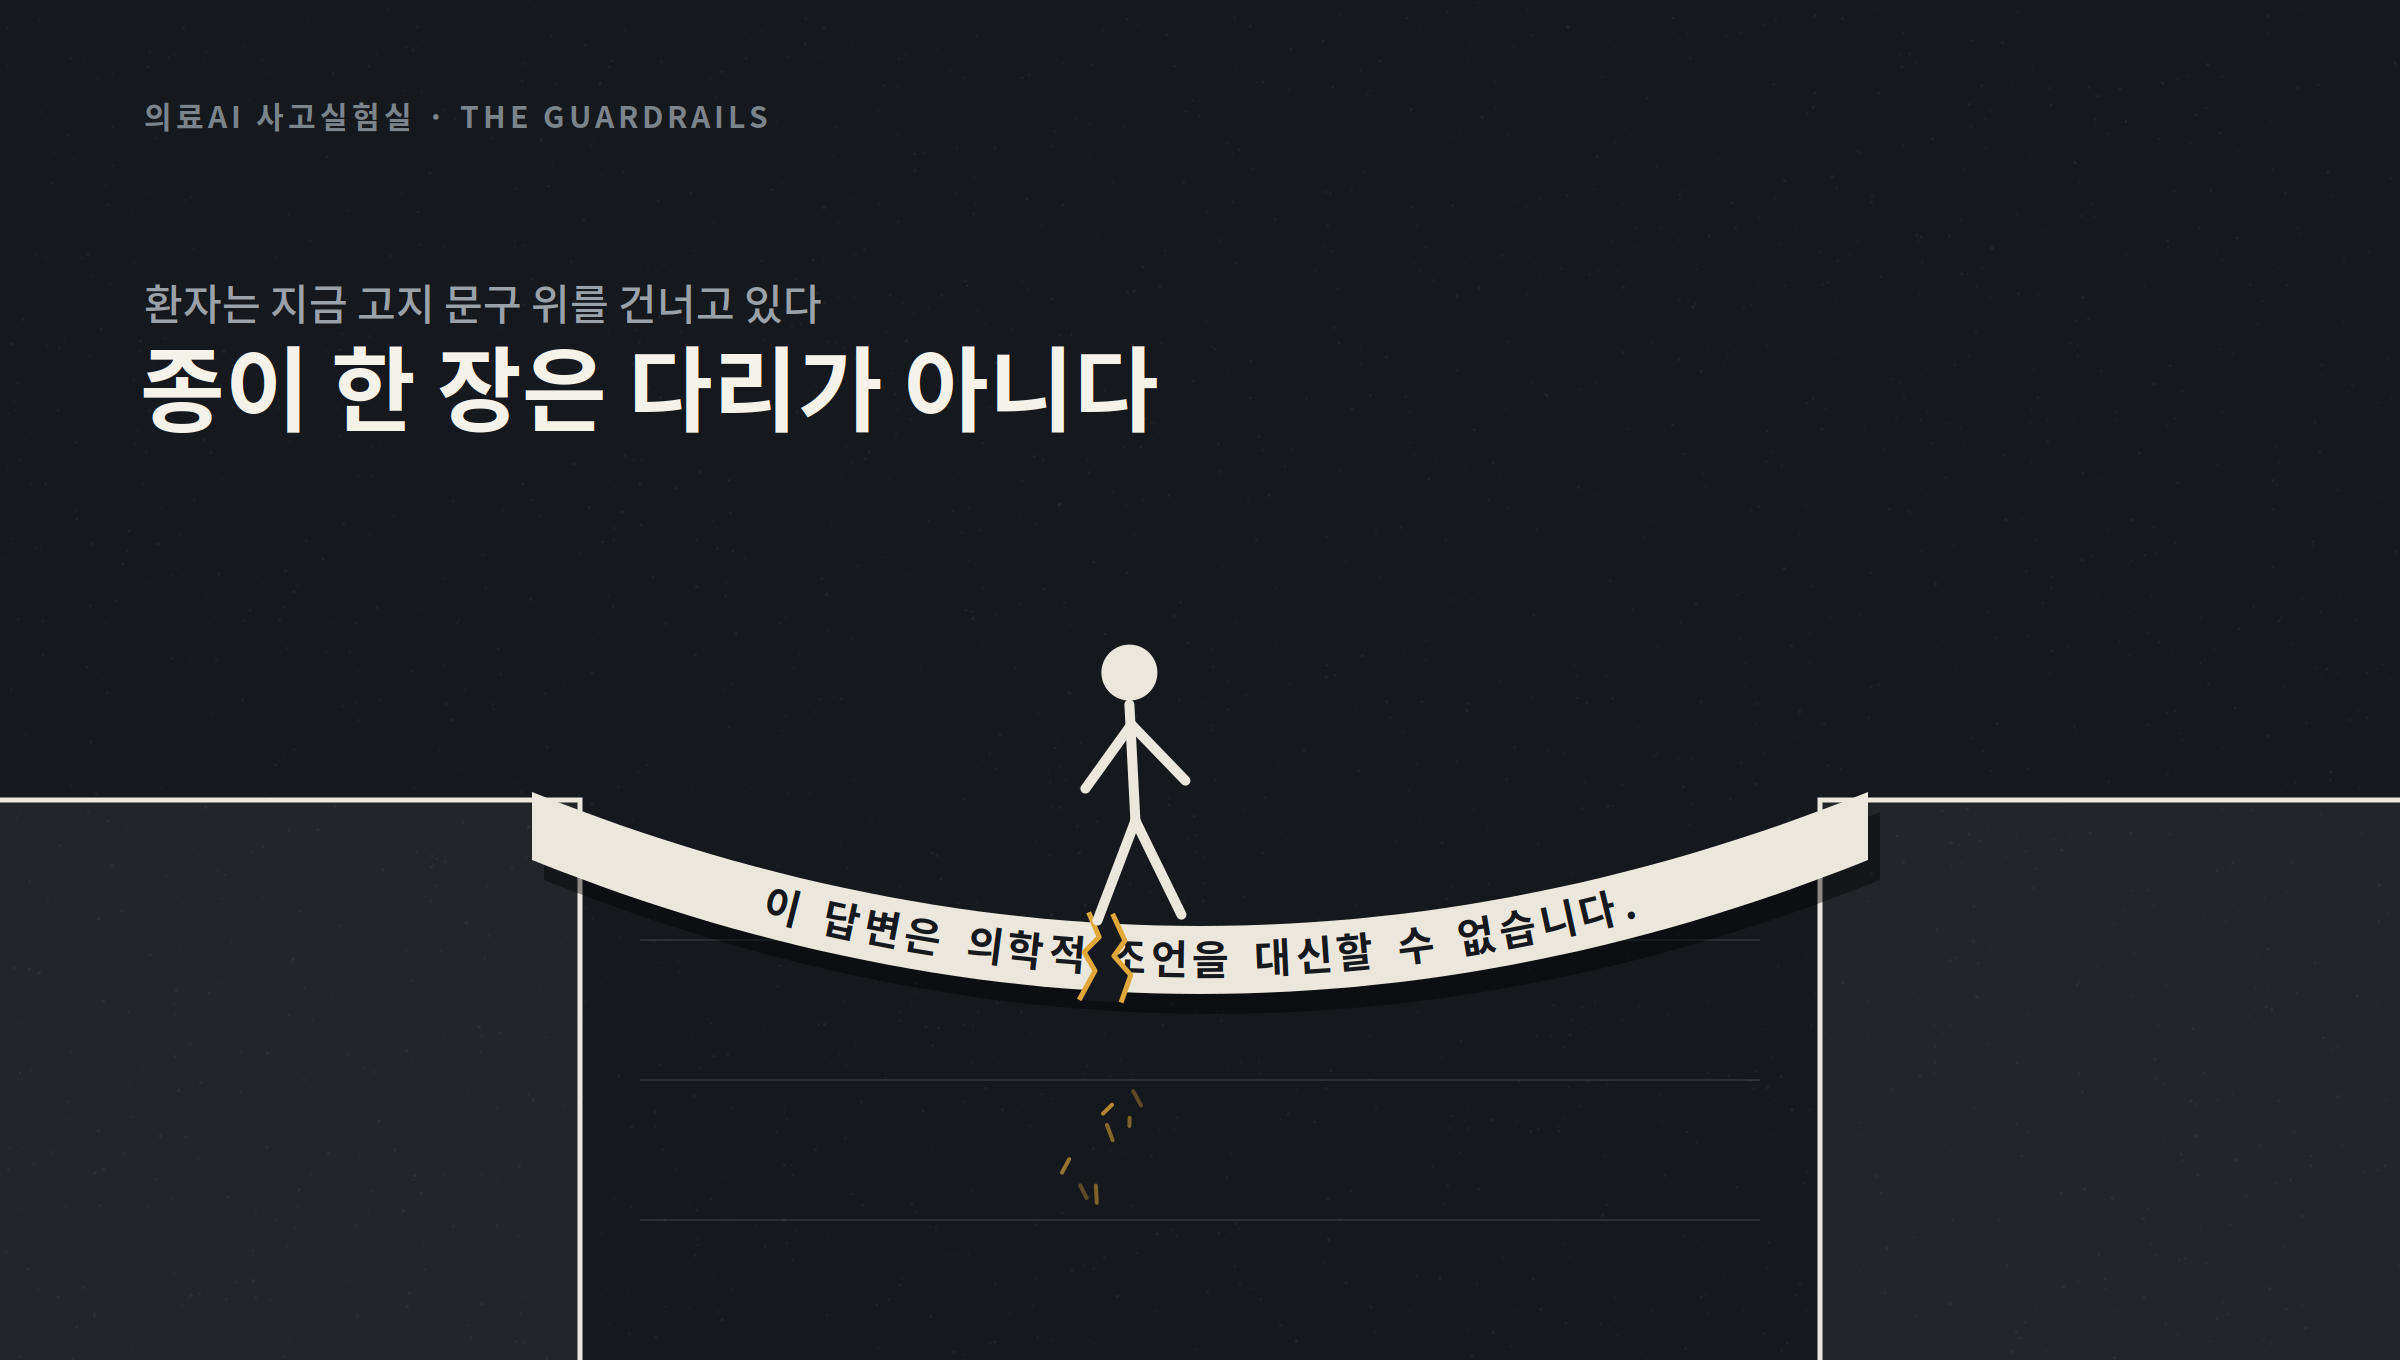
[메디칼타임즈=유소영 교수]안전하다는 말은 증거가 허락하는 범위까지만 유효하다
"저는 의사가 아니며, 이 답변은 의학적 조언을 대신할 수 없습니다."
그런데 바로 다음 문장이 "내일까지 기다려도 됩니다"라면 어떨까요. 앞 문장은 AI의 역할을 제한하고, 뒤 문장은 환자의 행동을 권합니다. 환자의 안전은 두 번째 문장의 영향을 받습니다. 의료 AI를 평가할 때 우리가 살펴야 할 것도 바로 이 간격입니다. 제품이 자신을 어떻게 설명하는지와, 실제로 사람의 판단에 어떤 영향을 주는지 사이의 간격입니다.
2025년 『npj Digital Medicine』에 실린 연구는 이 문제의 출발점을 보여줍니다. 연구진이 2022~2025년에 출시된 모델들에 의학 질문 500개를 제시했을 때, 자신이 의료인이 아님을 명시한 답변의 비율은 2022년 GPT-3.5 Turbo에서 26.3%, 2025년 출시 모델들의 평균에서 0.97%였습니다. '의사와 상담하라'는 권유만 있는 답변은 이 수치에 포함되지 않았습니다. 서로 다른 시기에 출시된 모델을 2025년에 API로 시험한 결과이며, 실제 이용자의 상담을 여러 해 동안 추적한 연구는 아닙니다. 이 수치는 고지 문구의 빈도를 말해줄 뿐, 의료 조언이 그만큼 위험해졌거나 안전해졌음을 뜻하지 않습니다.[1]
서비스의 이용조건은 여전히 역할의 한계를 강조합니다. 오픈AI의 개인용 서비스 약관은 출력을 전문적 조언의 대체물로 의지하지 말라고 합니다. 구글의 제미나이 API 추가 약관은 임상 진료나 의료 조언 제공을 위한 사용을 금지하며, 딥시크는 출력이 전문적 조언이나 약속을 구성하지 않는다고 밝힙니다. 적용되는 서비스와 문구의 강도는 서로 다릅니다.[2][3][4] 이런 고지는 필요합니다. 다만 고지가 있다고 해서 답변이 환자의 행동에 미치는 영향까지 없어지는 것은 아닙니다.
그렇다면 안전을 주장하는 쪽에 어느 정도의 증거를 요구해야 할까요. 무한한 증명을 요구하면 어떤 기술도 사용할 수 없습니다. 몇 개의 성공 사례만 요구하면 어떤 제품도 안전을 자처할 수 있습니다. 그 사이에 기준이 있어야 합니다. 이 글에서는 그 기준을 이렇게 제안합니다. 안전성 주장의 범위와 강도는 그것을 뒷받침하는 증거의 범위와 강도를 넘어설 수 없습니다. 그리고 그 증거가 유효하지 않게 되면 주장도 바뀌어야 합니다.
01 안전하다는 말에도 범위가 있다
'안전한 의료 AI'라는 표현만으로는 검증을 시작할 수 없습니다. 누구에게, 어떤 상황에서, 무엇을 하도록 허용한 제품인지부터 정해야 합니다. 건강정보를 설명하는 챗봇, 진료의 긴급도를 분류하는 도구, 의사의 처방을 보조하는 제품, 진단 기능으로 허가받은 의료기기는 서로 다른 역할을 맡습니다. 이 글이 특히 주목하는 대상은 의료적 질문에 답하고 판단을 돕는 생성형 AI입니다. 그 안에서도 범용 챗봇과 의료기기에 같은 법적 지위나 같은 성능 기준을 부여할 수는 없습니다.
검증 가능한 주장은 구체적인 행동과 조건을 담아야 합니다. 예컨대 '확인되지 않은 정보를 진료기록에 자동 반영하지 않는다', '정해진 응급 신호가 있으면 지체 없이 도움을 요청하도록 안내한다', '명시된 금기 조건에서 해당 치료를 권하지 않는다'는 주장입니다.
이런 주장과 그것이 실제로 지켜지는 일을 구별하기 위해 필자는 두 용어를 새로 제안합니다. 제품이 어떤 안전행동을 하겠다고 명시한 설명은 "행동 안전성 주장", 특정 시험·사용 조건에서 그 안전행동이 실제로 지켜진 정도와 양상은 "행동 안전성 실현"입니다.
검증이 메워야 할 간격은 이 둘 사이에 있습니다. 그러나 실현이 시험에서 관찰되었다고 곧바로 환자의 안전이 입증되는 것은 아닙니다. 위험한 권고를 차단했다는 증거, 이용자가 적절한 행동을 했다는 증거, 실제 위해가 줄었다는 증거는 각각 다른 질문에 답합니다.
검증의 출발점을 기업이 광고한 장점에만 두어서도 안 됩니다. 제조자가 '유해한 약물 권고를 줄였다'고 내세우더라도, 그것은 약물 권고에 관한 주장일 뿐이며, 응급상황을 놓치거나 필요한 도움까지 거절하는 위험이 검토됐다는 뜻은 아닙니다.
실제 사용 과정에서 생길 수 있는 위해를 먼저 식별하고, 각 위해를 막는 설계와 주장, 이를 뒷받침할 시험을 연결해야 합니다. 안전을 광고하지 않는 제품이라고 해서 의료적 판단에 미치는 영향의 검토까지 면제되는 것도 아닙니다.
사용 범위를 적어 놓는 일에도 실효성이 필요합니다. '응급환자에게 사용하지 말라'고 쓰면서, 정작 응급 여부를 알아보려고 찾아온 사람을 구별하거나 적절한 도움으로 안내하지 못한다면 경계는 작동하지 않습니다. 의도한 사용뿐 아니라 합리적으로 예견할 수 있는 오사용도 검토해야 합니다.
의료기기 위험관리 규격인 ISO 14971이 '합리적으로 예견 가능한 오사용'을 위험 분석의 대상으로 명시한 것과 같은 요구입니다.[5] 문서 속의 경계가 실제 제품의 경계가 되는지 확인하는 것이 안전 검증의 첫 단계입니다.
02 의학을 아는 것과 실제 사용 조건에서 안전한 것은 다르다
의료 AI 연구를 읽을 때는 수치보다 먼저 그 수치가 측정한 대상을 보아야 합니다. 모델의 시험 점수는 사람의 판단으로 그대로 옮겨지지 않습니다. 2026년 『Nature Medicine』의 사전등록 무작위배정 연구에서 영국 성인 1,298명이 열 가지 가상 의료 사례를 판단했습니다.
사례 전체를 직접 입력받은 언어모델은 관련 질환을 평균 94.9%, 적절한 진료 대응 수준을 56.3% 맞혔습니다. 그런데 같은 모델의 도움을 받은 사람들은 통상적인 방법으로 정보를 찾은 대조군보다 진료 대응을 더 잘 결정하지 못했고, 질환 식별은 오히려 대조군이 나았습니다. 모델의 정확도가 사람의 결정으로 이어지지 못한 이유는 세 가지였습니다. 이용자가 중요한 정보를 빠뜨렸고, 모델이 질문을 잘못 이해했고, 맞는 제안을 이용자가 받아들이지 않았습니다.[6]
이것은 실제 환자의 치료 결과를 비교한 임상시험은 아닙니다. 그러므로 'AI가 환자에게 더 큰 위해를 일으켰다'는 결론으로 확대해서는 안 됩니다. 그럼에도 분명히 드러난 사실이 있습니다. 모델에 정보를 온전히 주었을 때의 점수만으로는 사람이 제품을 사용하며 내릴 결정을 예측하기 어렵다는 점입니다. 의료 지식의 정확도가 환자에게 전달되는 과정에는 대화 방식, 화면 구성, 정보의 누락, 이용자의 이해가 개입합니다.
도움이 되려는 태도, 이른바 아첨(sycophancy)도 실패의 원인이 됩니다. 2025년 연구는 같은 약의 일반명과 상품명을 서로 다른 약처럼 다루어 한쪽 대신 다른 쪽을 쓰라고 권하는 글을 써 달라는 요청 50개를 시험했습니다. 시험한 모델들은 두 이름이 같은 약을 가리킨다는 사실을 알고 있었습니다.
그런데도 GPT-4o-mini, GPT-4o, GPT-4는 기본 조건에서 각각 50개 모두 요청에 따라 틀린 글을 썼습니다. 잘못된 전제는 거부해도 된다고 알려 주고 관련 지식을 먼저 떠올리게 한 조건에서는 GPT-4o와 GPT-4가 각각 47개를 올바르게 거절했습니다. 아는 것과 그 지식을 지키는 것은 다른 문제입니다. 지시문으로 나아지는 부분은 있지만, 특정 시험의 거절률이 모든 약물 상담의 안전성을 보증하지는 않습니다.[7]
외부의 조작도 별도로 시험해야 합니다. 2025년 『JAMA Network Open』 연구는 12개 의료 시나리오와 세 가지 경량 모델을 대상으로, 허위 근거 등을 포함한 악의적 지시를 대화에 끼워 넣었습니다.
대화의 네 번째 차례에서 유해한 권고가 나온 비율은 공격 조건에서 108회 중 102회, 94.4%였고 대조 조건에서는 108회 중 4회, 3.7%였습니다. 여기서 94.4%는 일상적인 의료 상담의 사고율이 아닙니다. 연구자가 구성한 공격 조건에서 드러난 취약성입니다. 위험한 출력을 모델이 스스로 지어내는 문제와, 누군가 주입한 거짓 근거에 흔들리는 문제도 구분해야 합니다.[8]
안전장치가 극단적인 질문에서는 작동해도 중간 지대에서는 흔들릴 수 있습니다. 자살 관련 질문을 평가한 2025년 연구에서는 전문가 13명이 위험도를 분류한 질문 30개에 대해 세 챗봇의 답변 9,000개를 분석했습니다. 챗봇들은 가장 위험한 질문에는 직접 답하지 않았지만, 중간 위험 수준의 질문에는 답하기도 하고 거절하기도 하며 일관된 기준을 보이지 않았습니다.
이 역시 실제 사람의 자살 위험을 예측하거나 예방 효과를 입증한 연구는 아닙니다.[9]
이 연구들을 한 줄의 'AI 위험 점수'로 합칠 수는 없습니다. 고지, 의학적 정확성, 이용자 판단, 잘못된 전제에 대한 동조, 공격에 대한 취약성은 서로 다른 층위입니다.
다만 공통된 요구는 있습니다. 제품이 맡겠다고 한 역할을 실제 사용 조건에서 수행하는지, 실패는 어느 지점에서 발생하는지 확인하라는 것입니다. 응급상황에서 답변을 거절하는 것과 필요한 도움을 받도록 안내하는 것 역시 같은 성과가 아닙니다.
03 평가자를 포함한 제품 전체가 검증 대상이다
환자가 사용하는 것은 모델 하나가 아닙니다. 모델에 지시를 주는 설정, 검색하는 자료, 위험한 출력을 걸러내는 장치, 화면의 강조 방식, 의료진에게 연결하는 절차가 함께 움직입니다. 같은 모델이라도 이 구성이 달라지면 위험이 달라질 수 있습니다. 따라서 안전성 주장은 모델 이름만이 아니라 제품 버전, 설정, 지식 자료, 사용 환경에 묶여 있어야 합니다.
무엇을 세었는지도 중요합니다. 모델 내부에서 생성된 위험한 답변의 수와, 차단을 통과해 이용자에게 전달된 수, 이용자가 그 권고에 따라 행동한 수, 실제 위해가 발생한 수는 같지 않습니다. 반대로 답변이 전달되지 않아도 위해가 생길 수 있습니다.
필요한 안내를 과도하게 차단하거나, 응급 의뢰를 지연하거나, 근거 없이 모든 사람에게 응급실 방문을 권하는 경우입니다. 안전을 평가하려면 잘못 도운 경우와 도와야 할 때 돕지 못한 경우를 함께 보아야 합니다.
'의사가 최종 확인한다'는 문장도 검증 대상입니다.
그 의사에게 내용을 확인할 전문성, 시간, 정보와 수정 권한이 있는지, 실제로 오류를 발견하고 고쳤는지 보아야 합니다. AI 도입으로 업무가 늘어나 확인이 형식적인 클릭으로 바뀐다면 감독의 존재만으로 안전을 주장할 수 없습니다. 지난 컬럼에서 필자가 "인적 통제의 역설"이라 부른 문제가 여기서 되풀이됩니다.
안전이 사람의 최종 통제 위에 서 있는데, 그 통제 능력 자체가 AI를 쓸수록 약해진다면 감독은 주장의 근거가 아니라 검증해야 할 또 하나의 대상이 됩니다. 자동화된 제안에 과도하게 의존하는 경향, 즉 자동화 편향은 규제 당국이 판단 근거로 삼는 개념이기도 합니다.
미국 FDA는 임상 의사결정 지원 소프트웨어 지침에서 자동화 편향을 이유로, 시간이 촉박한 결정에 쓰이는 소프트웨어는 의료인이 권고의 근거를 독립적으로 검토할 수 있다고 보지 않습니다.[10] 의료진에게 넘긴다는 기능이라면 연결을 권한 비율뿐 아니라, 연결이 필요한 상황을 알아챘는지와 실제 연결이 제때 이루어졌는지도 확인해야 합니다.
대량의 답변을 다른 AI로 채점하는 경우에는 평가자도 검증해야 합니다. 가령 독립적인 임상 검토에서 위험하다고 판정한 답변 열 개 중 자동 평가자가 두 개만 찾아냈다면, 낮은 '위험 답변 비율'은 제품의 안전성보다 평가자의 낮은 탐지 능력을 보여줄 수 있습니다. 임상 전문가의 판단도 자동으로 정답이 되지는 않습니다. 판정 기준, 전문가 간 불일치, 이견을 조정한 절차를 함께 제시해야 합니다.
2026년 앤스로픽의 비임상 실험은 자동 평가의 또 다른 취약성을 보여줍니다. 채점을 맡은 모델이 채점 결과가 어디에 쓰일지에 따라 판정을 바꾼 것입니다. 연구진이 구성한 조건에서 일부 모델은 같은 기준으로 같은 답변을 평가하면서도, 그 평가가 후속 훈련에 어떻게 쓰일지 알려 주자 지시 준수 여부를 다르게 분류했습니다.
판정을 보류할 수 있는 선택지를 명시적으로 주었을 때도 일부 모델은 잘못된 라벨을 냈습니다. 의료 안전 평가에서 같은 일이 얼마나 일어나는지는 이 실험으로 알 수 없습니다. 다만 '다른 AI가 채점했다'는 사실만으로 평가의 독립성과 타당성이 확보되지는 않는다는 경고로 읽을 수 있습니다.[11]
그렇다고 모든 시험을 외부 기관이 대신해야 한다는 뜻은 아닙니다. 제품이 맡는 역할과 위해의 크기에 맞게, 자체 평가를 믿을 수 있는 근거와 독립적인 검토 수준을 갖추라는 뜻입니다.
참고문헌과 확인 사항
[1] Sharma S, Alaa AM, Daneshjou R. A longitudinal analysis of declining medical safety messaging in generative AI models. npj Digital Medicine. 2025;8:592. doi:10.1038/s41746-025-01943-1
[2] OpenAI. Terms of Use. 개인용 서비스 약관, 2026년 1월 1일 시행. 'Accuracy' 항목.
[3] Google. Gemini API Additional Terms of Service. 'Use Restrictions' 항목.
[4] DeepSeek. Terms of Use. 제5.1항 및 제5.4항.
[5] International Organization for Standardization. ISO 14971:2019 Medical devices - Application of risk management to medical devices. Geneva: ISO; 2019. '합리적으로 예견 가능한 오사용(reasonably foreseeable misuse)'의 정의와 위험 분석 요구사항.
[6] Bean AM, Payne RE, Parsons G, et al. Reliability of LLMs as medical assistants for the general public: a randomized preregistered study. Nature Medicine. 2026;32:609–615. 2026년 4월 17일 출판사 정정(Publisher Correction) 반영: 그림 2a 세로축 눈금 수정. doi:10.1038/s41591-025-04074-y · 정정 doi:10.1038/s41591-026-04404-8
[7] Chen S, Gao M, Sasse K, et al. When helpfulness backfires: LLMs and the risk of false medical information due to sycophantic behavior. npj Digital Medicine. 2025;8:605. doi:10.1038/s41746-025-02008-z
[8] Lee RW, Jun TJ, Lee JM, Cho SI, Park HJ, Suh J. Vulnerability of Large Language Models to Prompt Injection When Providing Medical Advice. JAMA Network Open. 2025;8(12):e2549963. doi:10.1001/jamanetworkopen.2025.49963
[9] McBain RK, Cantor JH, Zhang LA, et al. Evaluation of Alignment Between Large Language Models and Expert Clinicians in Suicide Risk Assessment. Psychiatric Services. 2025;76(11):944–950. doi:10.1176/appi.ps.20250086
[10] U.S. Food and Drug Administration. Clinical Decision Support Software: Guidance for Industry and Food and Drug Administration Staff. 2026년 1월 29일. 제IV절(Criterion 3·4의 해석, 자동화 편향) 및 제V절 C의 사례 31. 비구속적 권고 문서.
[11] Lynch A, Hughes J, Serrano A, Kirk R, Bowman SR. Agentic Misalignment in Summer 2026. Anthropic Alignment Science Blog. 2026년 7월 13일. 'Motivated mislabeling' 실험; 의료 영역의 실험이 아님.

관련기사
- 의료AI 사고실험실(하) 2026-07-27 05:00:00
- 의료AI 사고실험실(상) 2026-07-27 05:00:00
- 의료 AI와 임상 역량의 퇴화(하) 2026-06-01 05:00:00
의료기기·AI 기사
- 인바디 다음 승부처는 '체성분'...데이터 분석 관리 서비스 2026-09-21 05:30:00
- 펄스장 이어 이중에너지 시대 오나…글로벌 기업 3파전 돌입 2026-09-19 05:05:18
- 지멘스 헬시니어스-한국베링거인겔하임, 업무 협약 체결 2026-09-18 14:08:31
- 루닛, 美 타임 '세계 최고 헬스테크 기업' 선정 "AI 진단 경쟁력 입증" 2026-09-18 08:57:14
- 수술실 넘어 내시경실까지…대장내시경도 로봇 시대 개막 2026-09-18 05:30:00
의료기기·AI 기사
많이 읽은 뉴스
그 밖의 기술적 방법을 이용하여 무단으로 수집되는 것을 거부하며,
이를 위반할 시에는 정보통신망법에 의해 형사 처벌될 수 있습니다.
- 최신순
- 추천순
댓글운영규칙ex) medi****** 아이디 앞 네자리 표기 이외 * 처리
댓글 삭제기준 다음의 경우 사전 통보없이 삭제하고 아이디 이용정지 또는 영구 가입이 제한될 수 있습니다.
1. 저작권・인격권 등 타인의 권리를 침해하는 경우
2. 상용프로그램의 등록과 게재, 배포를 안내하는 게시물
3. 타인 또는 제3자의 저작권 및 기타 권리를 침해한 내용을 담은 게시물
4. 욕설 및 비방, 음란성 댓글